椰椰躺平的时光
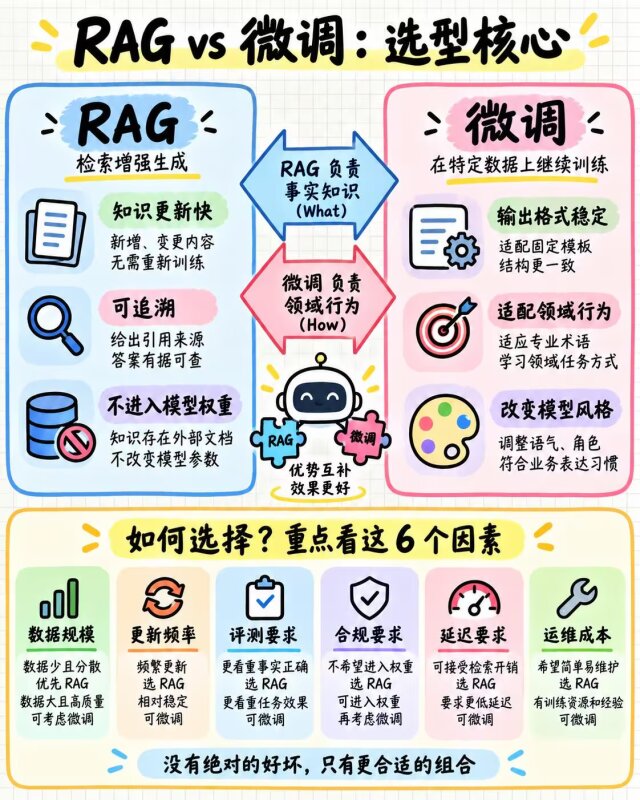
Hot037知识总更新,你选RAG还是微调? 很多同学在构建大模型应用时,会在RAG(检索增强生成)和微调之间纠结。其实两者解决的是不同维度的问题:RAG是在推理时把外部知识注入上下文,不改模型参数;微调是更新模型权重,让行为内化。 面试官真正关心的是质量、事实性、延迟、token成本、工具权限和可回滚性。如果你的知识频繁更新、需要可追溯引用、数据不能进权重,优先RAG;如果你需要稳定格式、领域行为或风格改变,微调更合适。 常见组合是RAG提供事实,微调改善行为——比如用RAG检索最新政策,用微调让模型输出固定JSON格式。决策时要看数据规模、更新频率、评测提升、合规、延迟和运维成本。 在真实项目链路中,输入经过检索/路由、上下文/工具、模型生成、验证/引用、监控等环节,每层都要量化:检索看Recall 最后要警惕三个边界:离线benchmark高分不代表线上可靠,prompt不是安全边界,更长上下文不一定更准确。用goldenset做回归测试、版本对比和灰度实验,把“看起来好”变成“可证明好”。LLM系统要让每个生成结果可评测、可追溯、可降级。